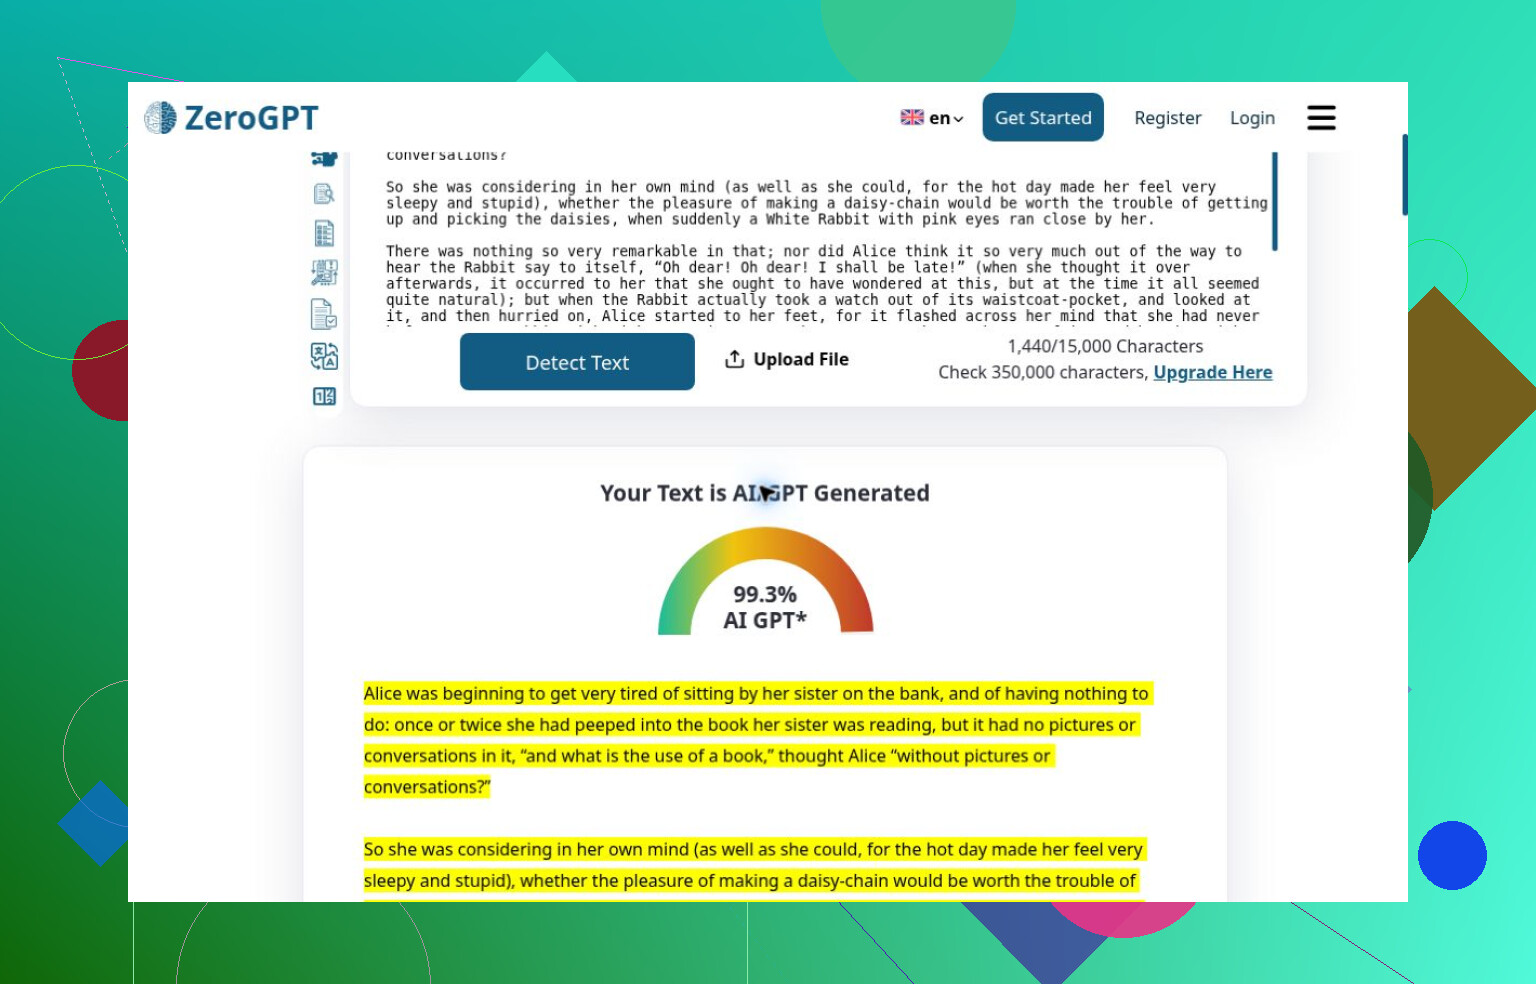
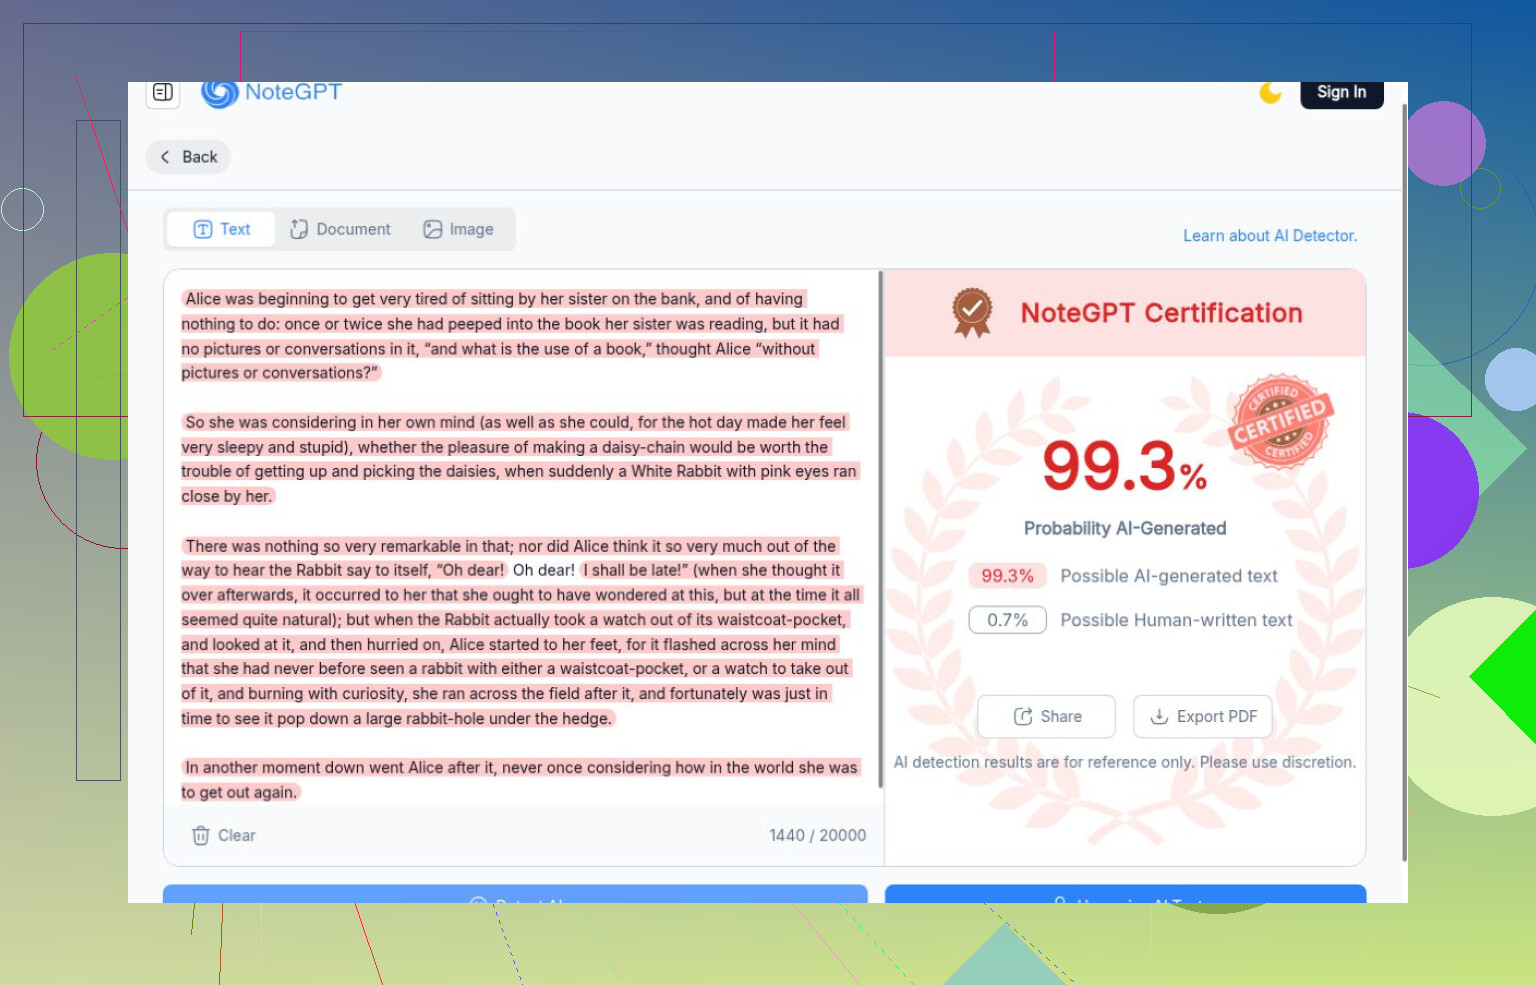
El error al que siempre vuelvo es tratar el porcentaje de un detector de IA como una medida de precisión. No lo es. Un resultado con un alto grado de confianza puede seguir siendo incorrecto, y una herramienta que detecta textos generados también puede señalar como tales textos genuinamente humanos. En mis comprobaciones, ZeroGPT y NoteGPT asignaron al fragmento de Lewis Carroll una puntuación de IA del 99,3 %. Un decimal con apariencia de gran sofisticación, pero unido a una respuesta equivocada.
Eso también cambia mi forma de interpretar los mejores resultados. Clever AI Detector fue la opción gratuita más práctica que probé, pero distingo entre comodidad, clasificaciones correctas y solidez de las pruebas. Esos aspectos pertenecen a columnas diferentes, aunque una web prefiera una gran insignia verde.
Empezar por lo que la muestra permite afirmar
Utilicé los mismos seis pasajes en inglés los días 2 y 3 de octubre de 2026, sin modificar el texto entre herramientas. El material generado incluía un ensayo, un memorando empresarial, una paráfrasis y un relato personal ficticio. Junto a ellos, utilicé un texto de Carroll y una versión ligeramente editada con IA.
Ese planteamiento me permitió comparar resultados completos sin cambiar las entradas de forma encubierta. No constituyó una evaluación general de precisión. Algunos pasajes estaban relacionados entre sí, y un fragmento literario representa solo una pequeña parte de la escritura humana. Los flujos de trabajo de pago, la cobertura multilingüe y una selección amplia de prosa humana moderna quedaron fuera de la prueba.
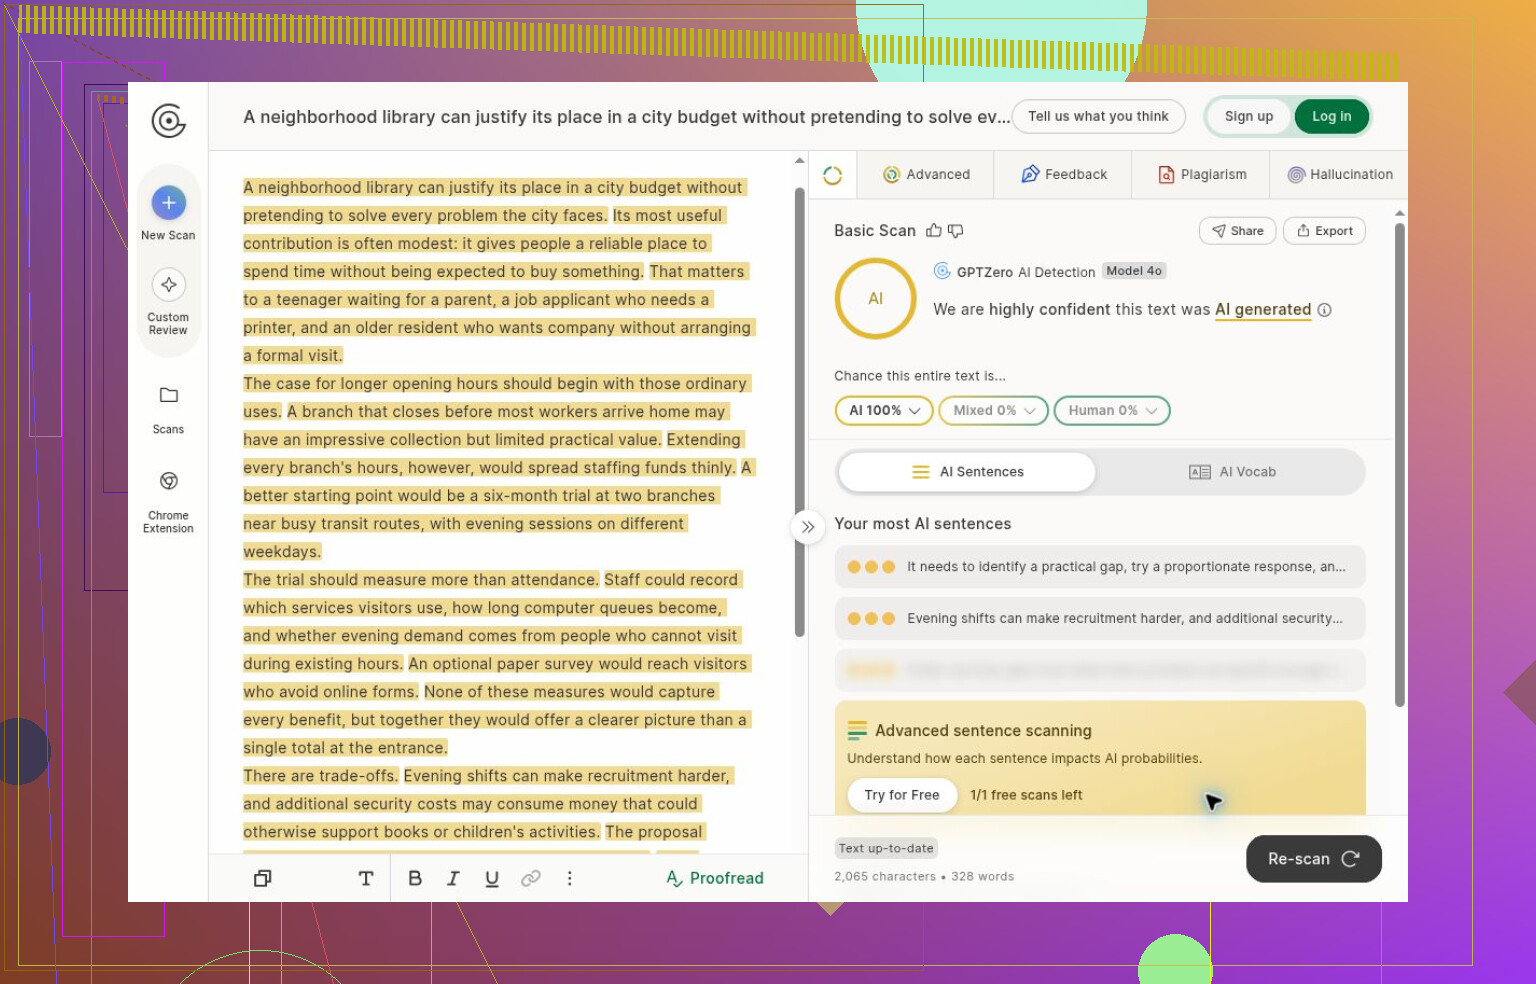
También excluí de los resultados los intentos sin terminar. Una pantalla de registro es un hallazgo sobre el acceso, no una clasificación fallida. Una puntuación antigua que permanece en pantalla después de sustituir el texto tampoco es una medición nueva. GPTZero me dio ese recordatorio concreto.
Las etiquetas requieren un cuidado similar. La confianza, la probabilidad y la proporción estimada de IA no miden cosas intercambiables. La confianza de Originality.ai se aplicaba a un veredicto basado en un umbral, no a un recuento de palabras generadas.
Los errores me dicen más que las insignias
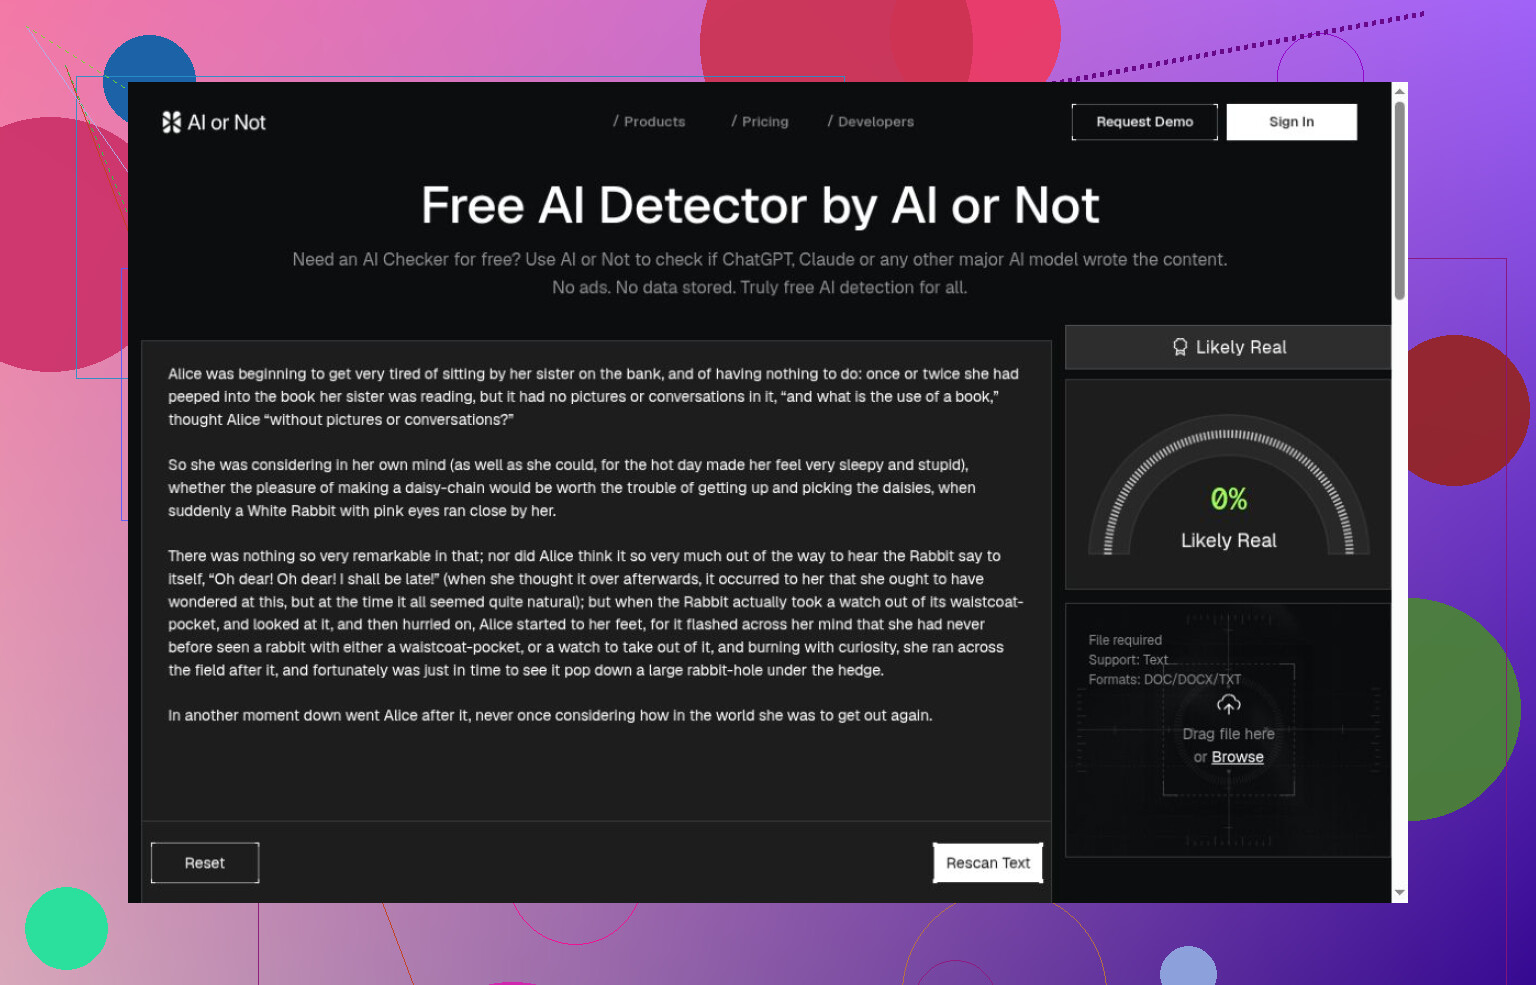
Los fallos más reveladores fueron en direcciones opuestas. ZeroGPT detectó los pasajes generados, pero asignó a Carroll una puntuación superior a la de todos ellos. NoteGPT también dio su puntuación de IA más alta al texto humano de control. Que las puntuaciones coincidan no demuestra que compartan tecnología.
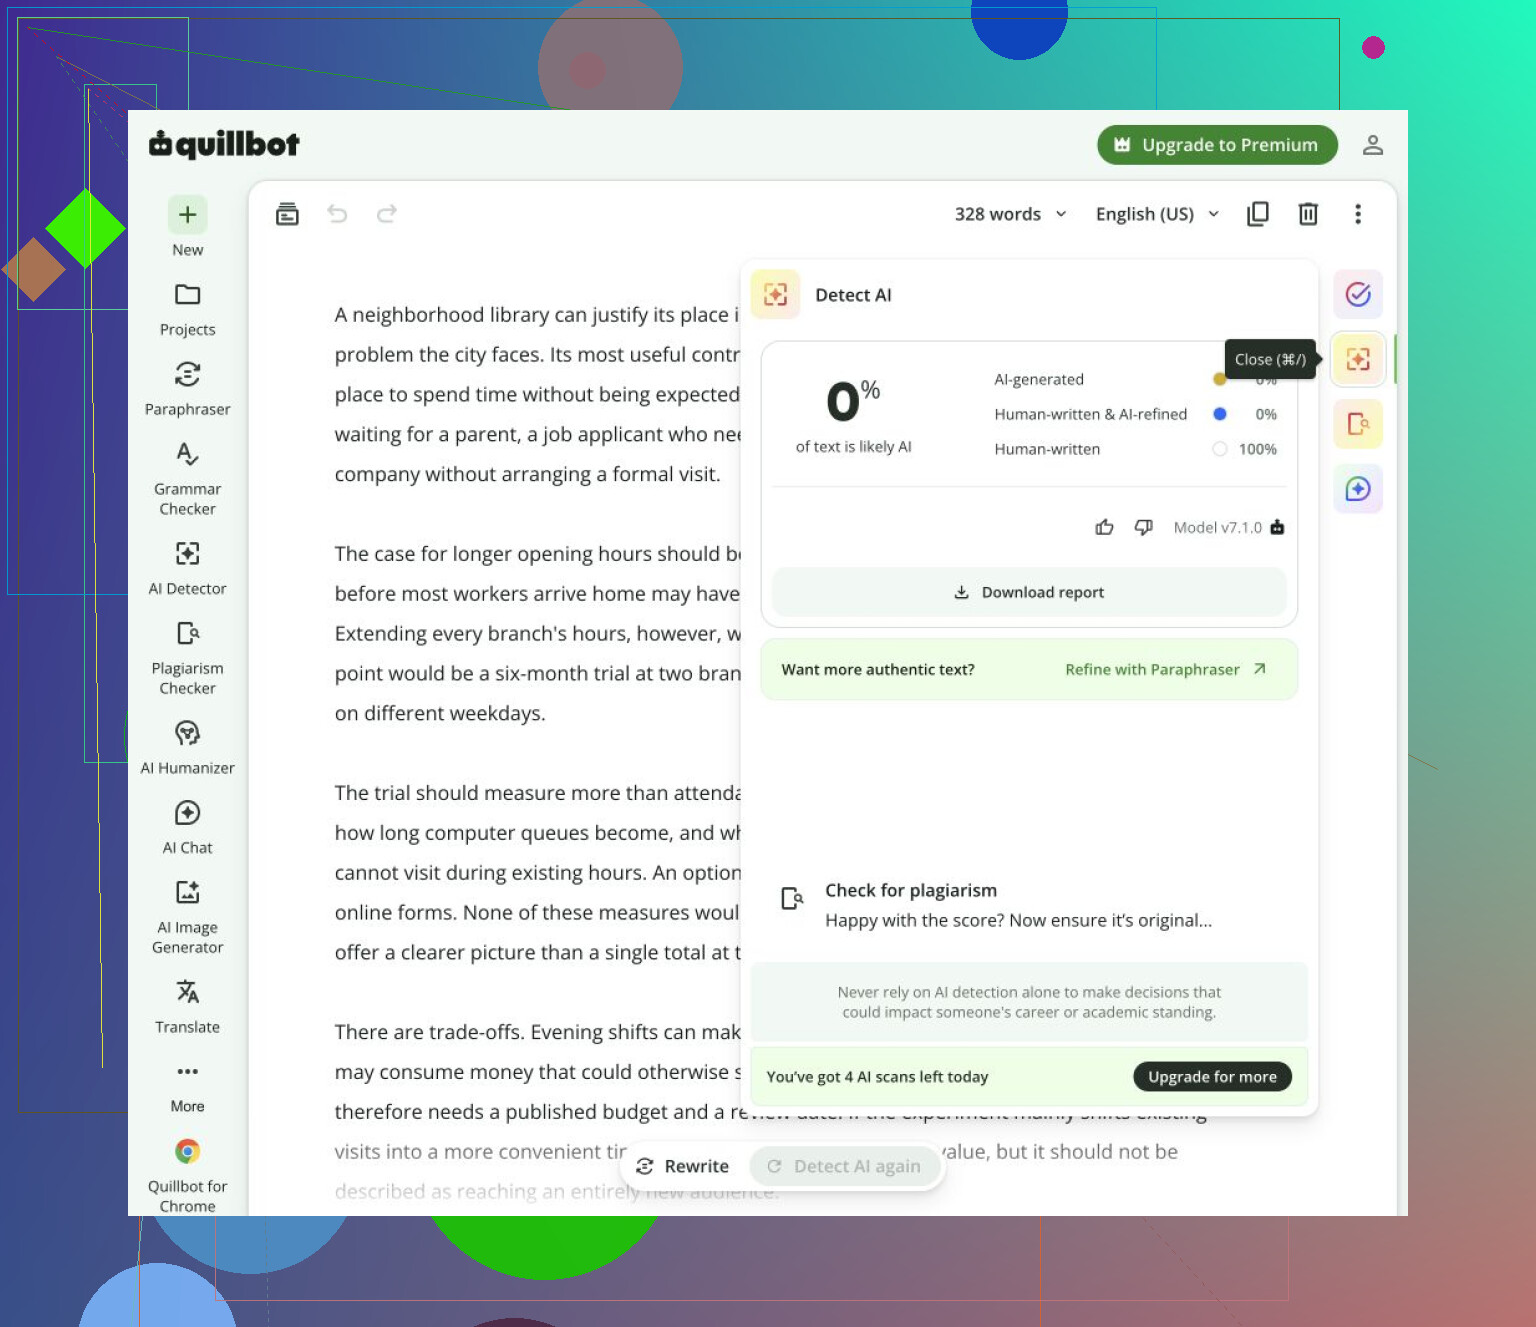
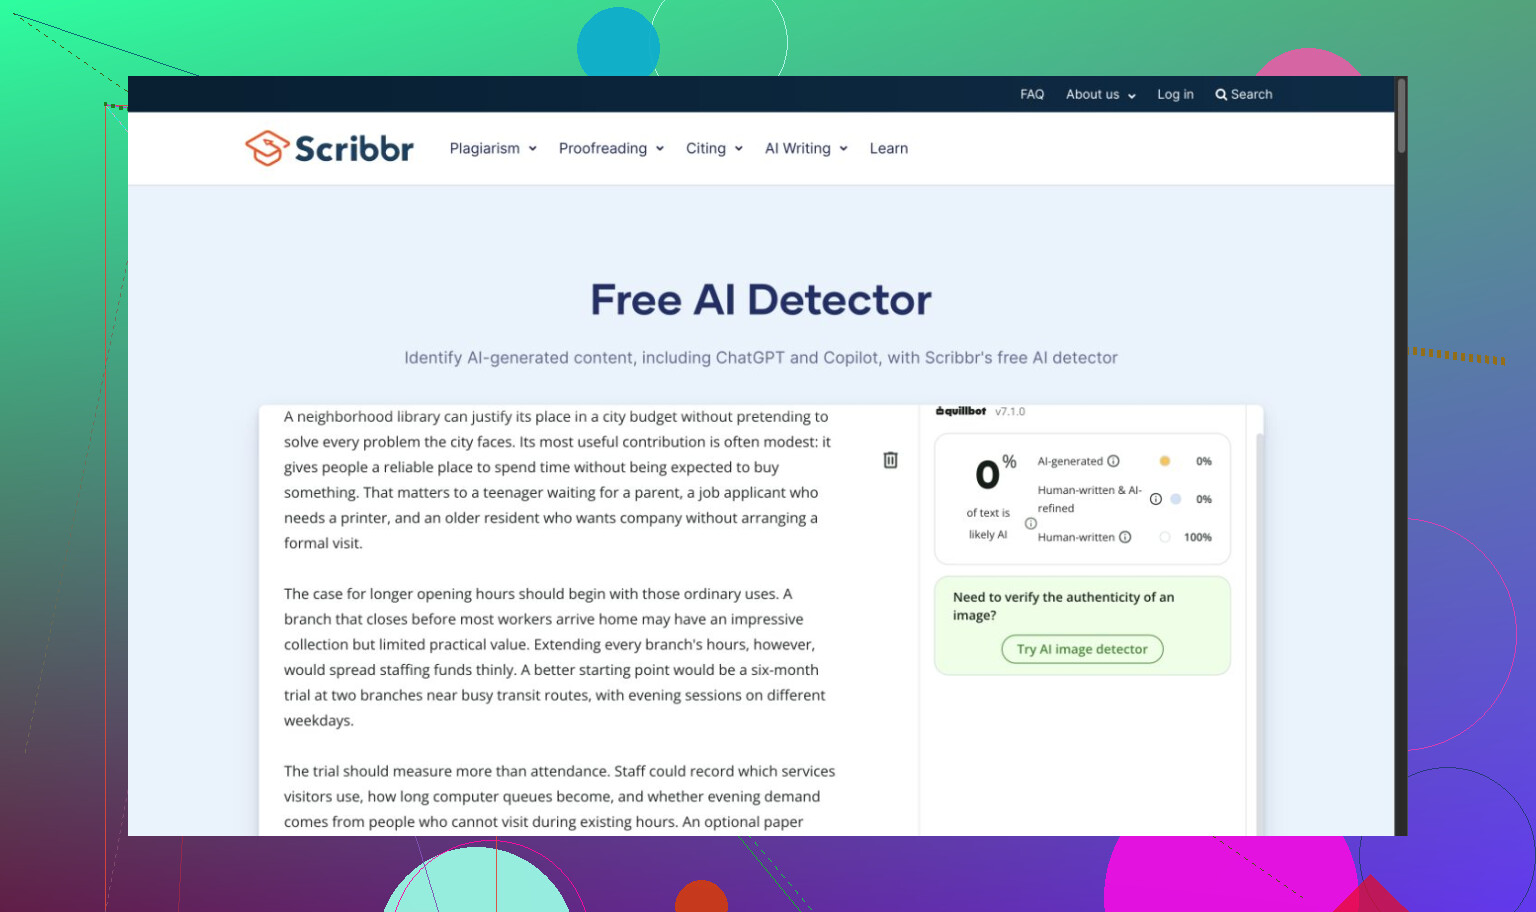
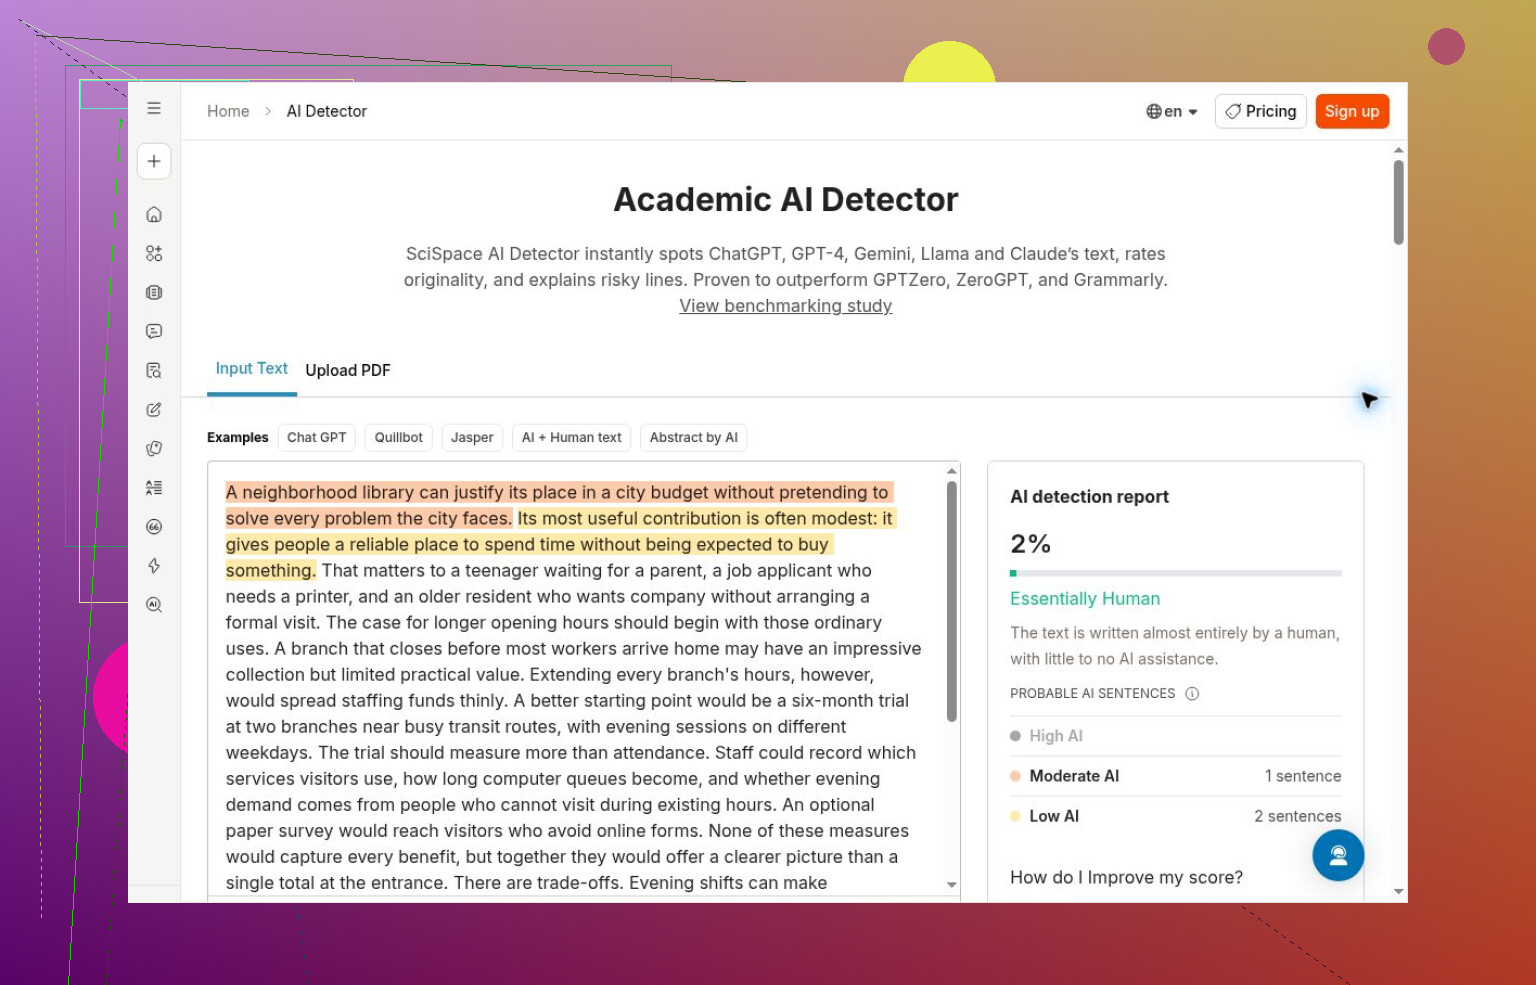
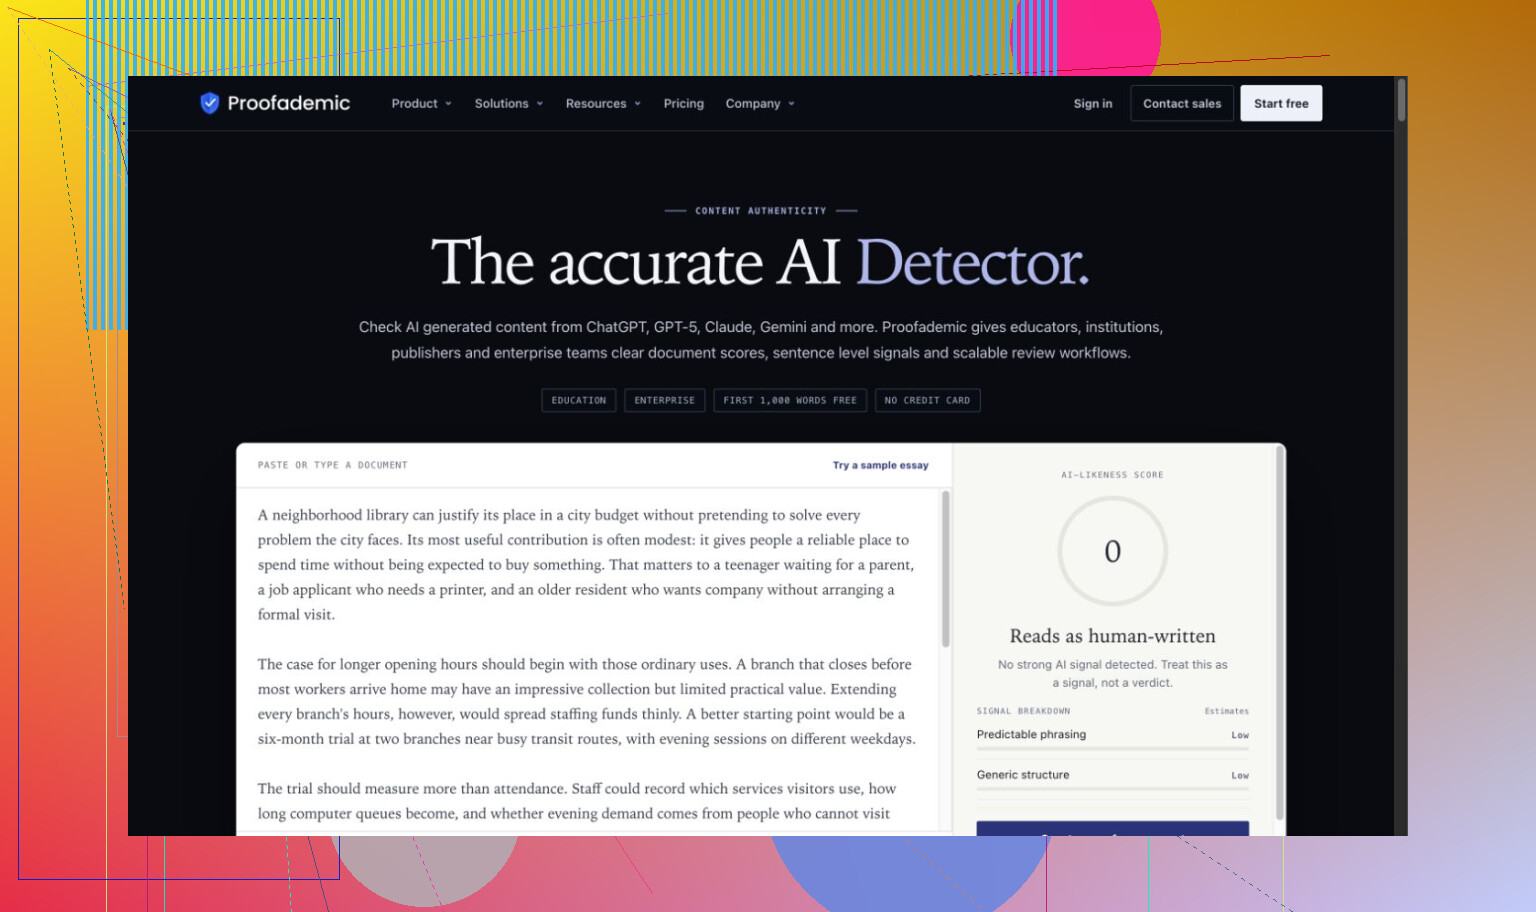
QuillBot tuvo el problema inverso: aceptó como humano cada pasaje generado. Scribbr no detectó el ensayo y aceptó a Carroll como humano; además, la presencia visible de la marca QuillBot me hizo ser prudente a la hora de contar esos servicios como votos independientes. Surfer no detectó el ensayo ni el relato generados. La demostración pública de Proofademic aceptó el ensayo como humano, mientras que SciSpace lo calificó como esencialmente humano, con un 2 % de IA detectada. Las explicaciones comprensibles no salvaron esos dictámenes.
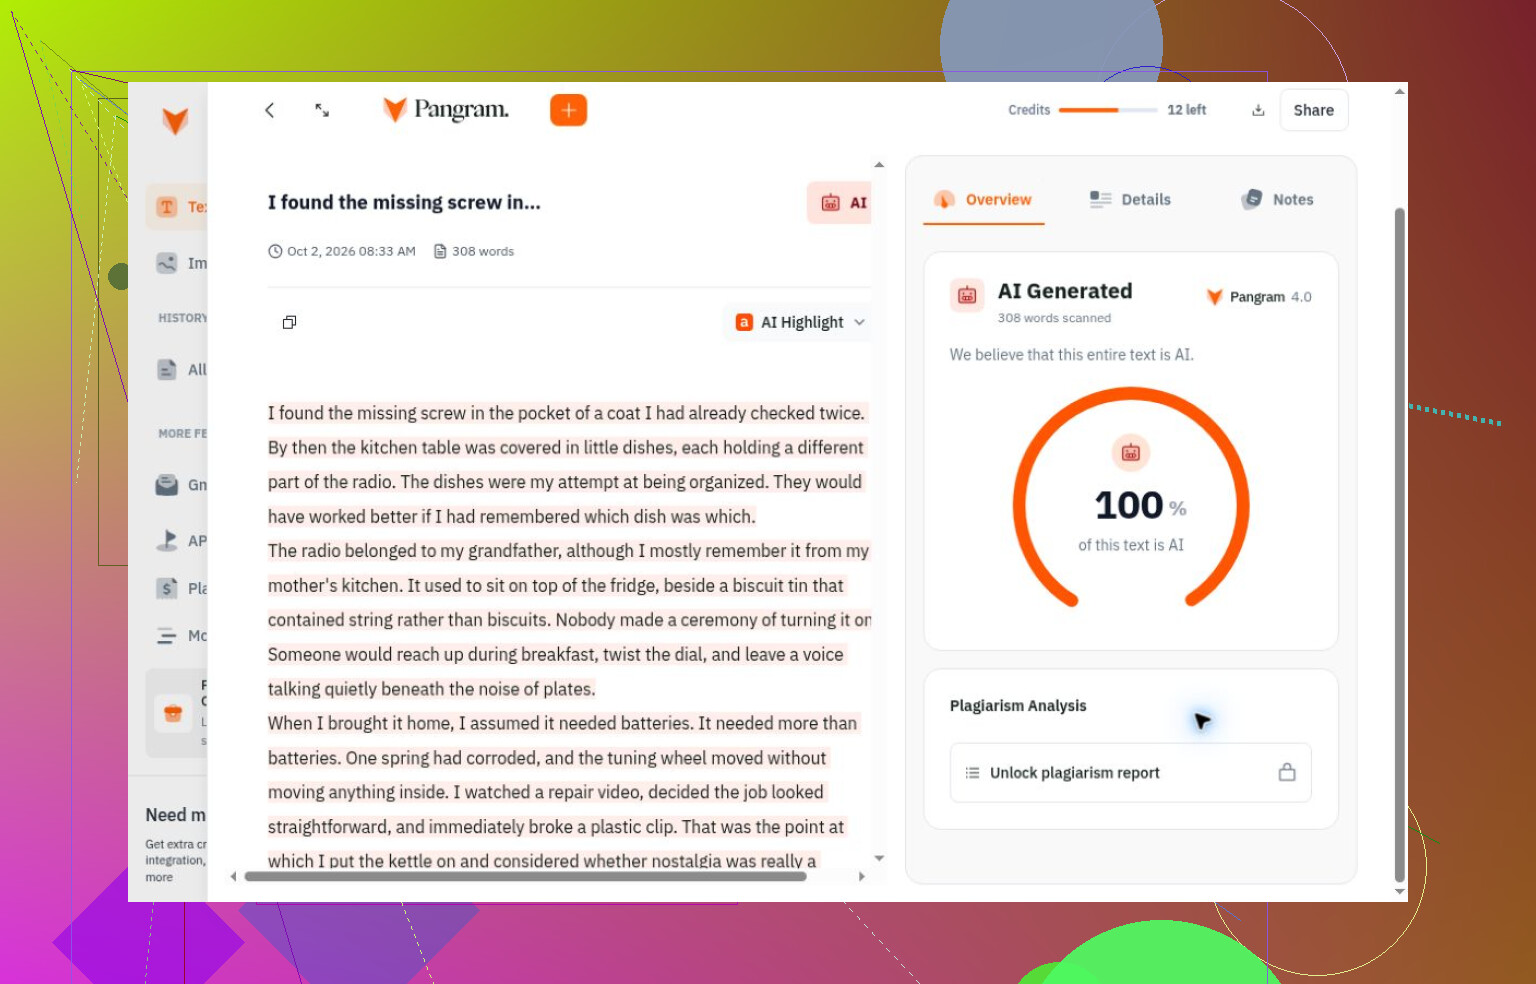
Los resultados completos más claros procedieron de Clever AI Detector, Pangram, Originality.ai y AI or Not. Su cobertura no fue la misma. Clever completó todo el conjunto sin pago ni registro; los demás agotaron antes el acceso como invitado o los créditos. Clever y Pangram también trataron como humano el pasaje humano ligeramente editado. Yo no convertiría sin más ese ejemplo de origen mixto en otro texto de control puramente humano.
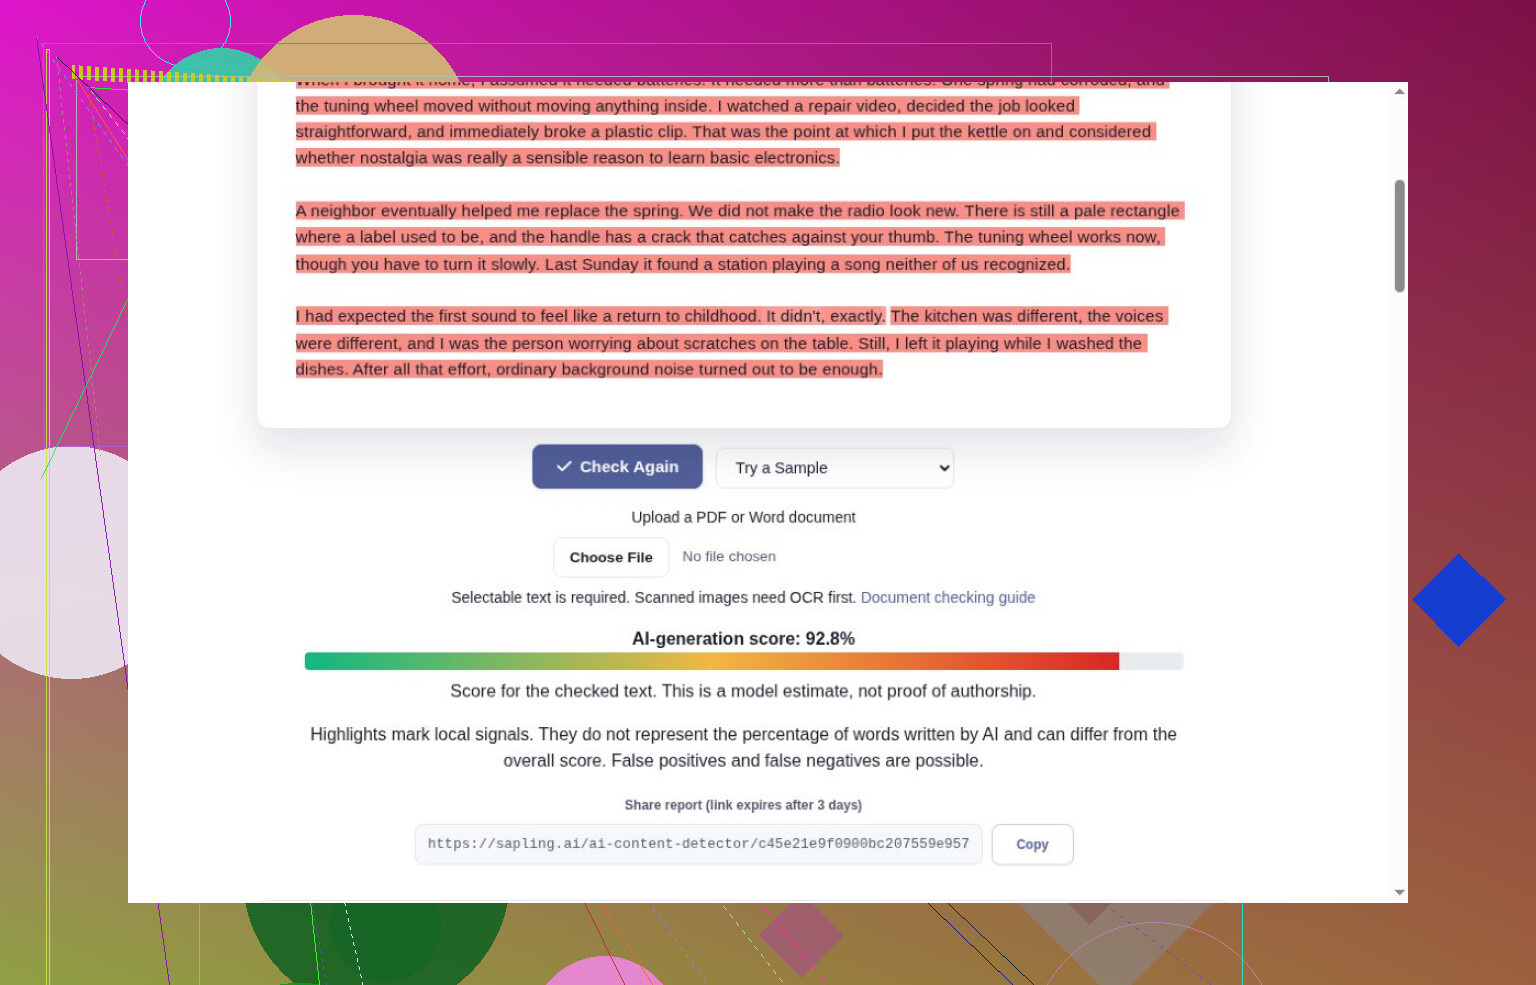
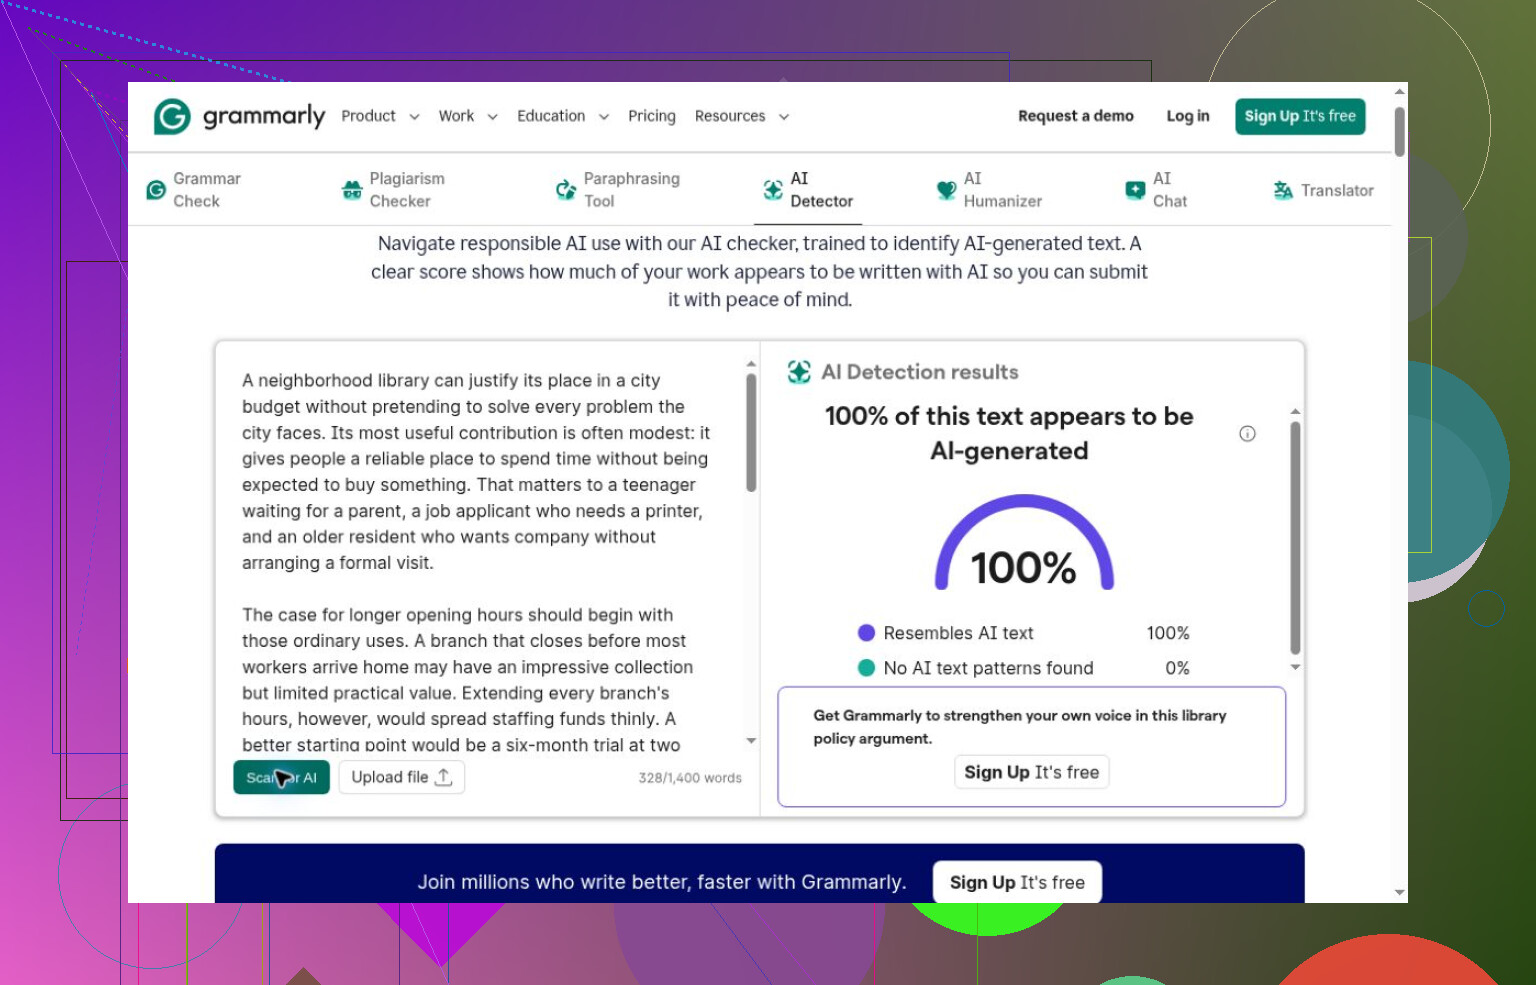
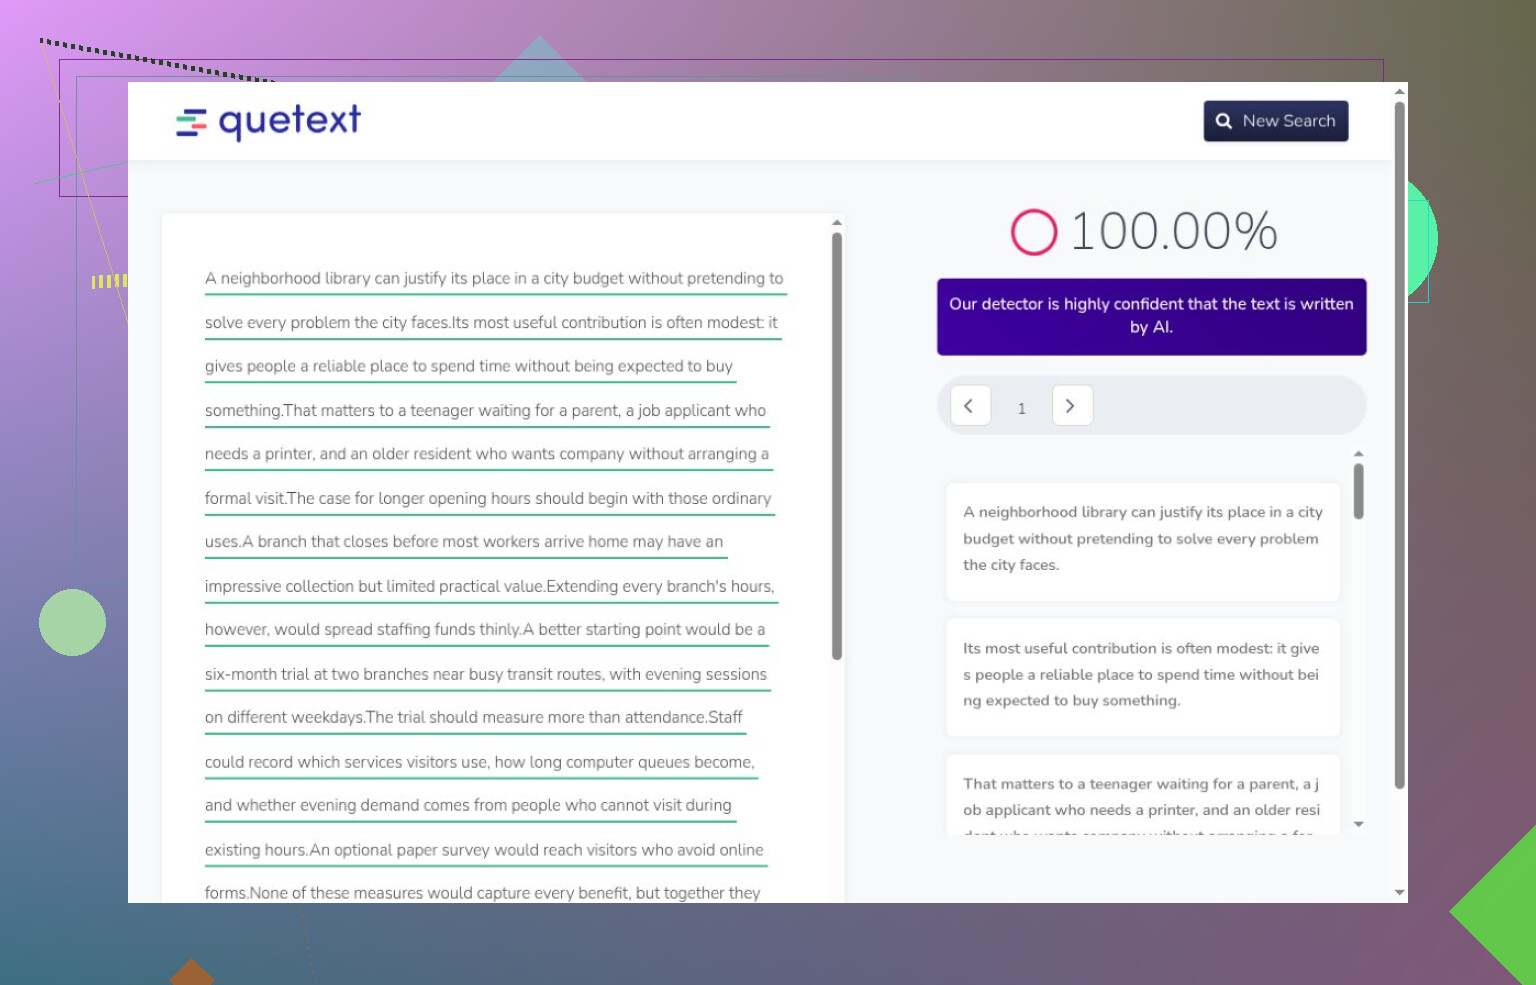
Sapling clasificó correctamente el relato completo y el fragmento humano, pero su análisis del ensayo quedó truncado. GPTZero detectó los textos generados que terminó de analizar antes de exigir el registro. Grammarly y Quetext señalaron correctamente el ensayo y luego bloquearon las comprobaciones adicionales como invitado. Al no haber un resultado para un texto humano, su comportamiento respecto a los falsos positivos quedó sin examinar.
El acceso se evalúa por separado
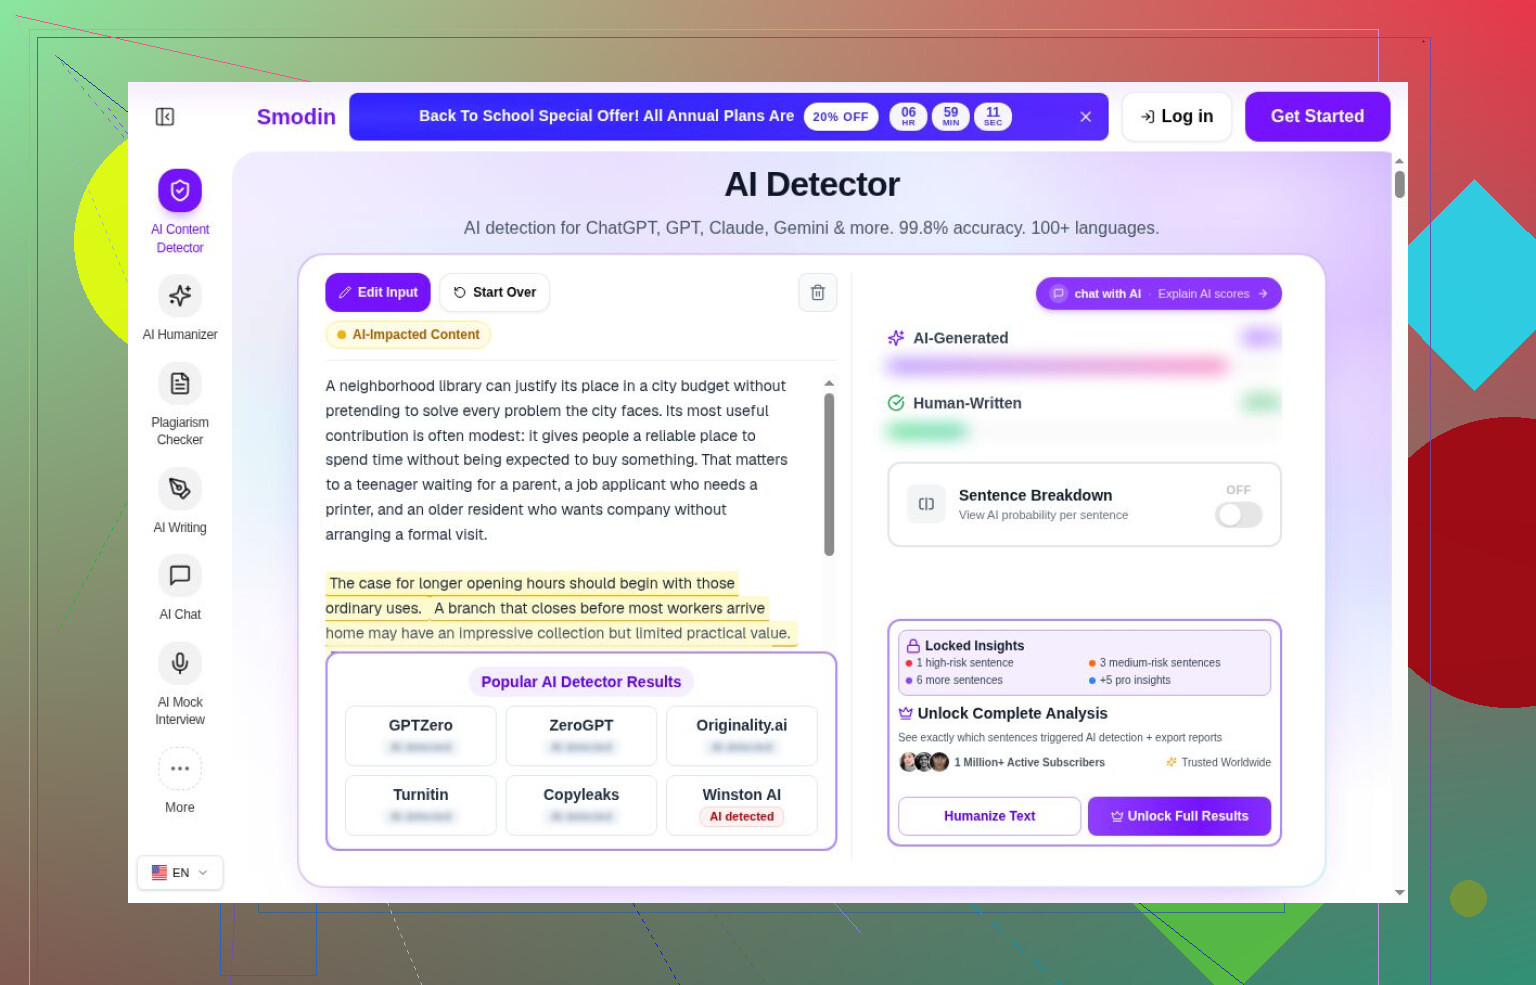
Decopy abrió un cuadro de inicio de sesión en lugar de devolver una puntuación. Smodin ocultó sus valores principales. AI Detector Pro y Winston AI exigieron registrarse, mientras que Turnitin requería acceso institucional y una licencia adicional. Me detuve ante las condiciones de uso aplicables de Copyleaks. Nada de eso demuestra una mala capacidad de detección.
Hive presentó una demostración orientada a contenido multimedia, con vías de análisis de texto mediante una extensión o una API que no probé. ContentDetector.AI llevó a una ficha de la extensión Moxby. Humanly se quedó en una ficha de aplicación revisada, con compras dentro de la aplicación, no en un detector evaluado.
Incluso las interfaces utilizables tenían salvedades: los créditos de Pangram dependían de la longitud, QuillBot se detuvo antes de alcanzar el límite anunciado para invitados y los colores de las frases y las etiquetas explicativas de Clever a veces discrepaban del resultado principal. No verifiqué el uso ilimitado ni la longitud máxima que anunciaba Clever.
Las imágenes siguientes documentan resultados y pantallas de acceso, incluidas ilustraciones de los proveedores en los casos en que no se realizó ningún análisis. Mantengo esa distinción al presentar las pruebas.
Mi veredicto: Clever se ganó el puesto de herramienta de comprobación gratuita en mi flujo de trabajo, no la autoridad para decidir sobre la autoría de nadie. Conservaría el texto, examinaría los borradores y las fuentes cuando los resultados discreparan y volvería a comprobar las condiciones de acceso antes de dar por sentada su disponibilidad. Estas herramientas pueden ayudar a decidir qué merece una revisión. No dejaría que decidieran quién merece una acusación.